Model bahasa besar atau Large Language Model (LLM) telah mengubah cara kita berinteraksi dengan mesin. Namun, teknologi ini memiliki kelemahan mendasar: ia hanya mengandalkan pengetahuan yang tersimpan dalam bobot parameternya saat proses pelatihan berakhir. Akibatnya, model sering kali memberikan jawaban yang terdengar meyakinkan tetapi faktanya salah, sebuah fenomena yang dikenal sebagai halusinasi. Untuk mengatasi masalah tersebut, para peneliti mengembangkan pendekatan bernama Retrieval-Augmented Generation.
Retrieval-Augmented Generation (RAG) adalah arsitektur kecerdasan buatan yang menggabungkan kemampuan generatif dari LLM dengan mekanisme pengambilan informasi dari sumber data eksternal. Alih-halih memaksa model mengingat semua hal, RAG memungkinkan AI untuk mencari dokumen atau basis data yang relevan terlebih dahulu sebelum menyusun jawaban. Pendekatan ini membuat respons yang dihasilkan jauh lebih akurat, mutakhir, dan dapat dilacak sumbernya.
Apa Itu Retrieval-Augmented Generation?
Pada dasarnya, Retrieval-Augmented Generation bekerja seperti seorang pustakawan cerdas yang membantu Anda menulis esai. Ketika Anda mengajukan pertanyaan, pustakawan tersebut tidak langsung menjawab dari ingatannya sendiri. Ia akan pergi ke rak buku, mencari referensi yang paling sesuai dengan pertanyaan Anda, membawa teks tersebut kembali, lalu merangkumnya menjadi jawaban yang mudah dipahami.
Dalam konteks teknis, RAG menambahkan lapisan pencarian (retrieval) ke dalam alur kerja model bahasa. Lapisan ini biasanya menggunakan basis data vektor untuk menyimpan representasi numerik dari dokumen. Ketika pengguna memasukkan perintah (prompt), sistem akan mencari potongan teks yang memiliki kemiripan makna tertinggi dengan perintah tersebut, lalu menyuntikkan teks temuan itu ke dalam konteks yang dibaca oleh LLM.
Cara Kerja Arsitektur RAG
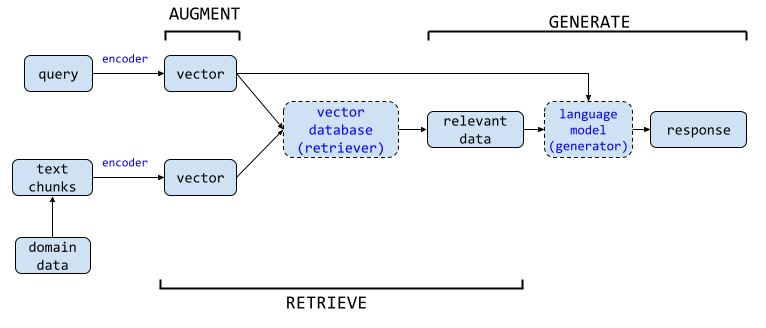
Untuk memahami bagaimana Retrieval-Augmented Generation beroperasi, kita perlu melihat tiga tahapan utamanya yang berjalan secara berurutan setiap kali ada permintaan dari pengguna.
1. Indeksasi Data
Sebelum sistem dapat digunakan, dokumen sumber harus diproses terlebih dahulu. Teks dari berbagai sumber seperti PDF, halaman web, atau basis data internal dipecah menjadi bagian-bagian kecil yang disebut chunks. Setiap potongan teks kemudian diubah menjadi vektor numerik menggunakan model embedding dan disimpan ke dalam basis data vektor. Proses ini memastikan bahwa pencarian semantik dapat dilakukan dengan cepat dan efisien.
2. Pencarian Informasi (Retrieval)
Ketika pengguna mengirimkan pertanyaan, pertanyaan tersebut juga diubah menjadi vektor menggunakan model embedding yang sama. Sistem kemudian melakukan pencarian kesamaan kosinus (cosine similarity) di dalam basis data vektor untuk menemukan potongan dokumen yang paling relevan dengan pertanyaan pengguna. Potongan-potongan teks ini diambil sebagai konteks tambahan.
3. Pembangkitan Respons (Generation)
Tahap terakhir adalah menggabungkan pertanyaan asli pengguna dengan dokumen yang berhasil ditemukan ke dalam satu prompt utuh. Prompt ini kemudian dikirimkan ke LLM. Karena model kini memiliki konteks spesifik yang relevan, ia dapat menghasilkan jawaban yang didasarkan pada fakta dari dokumen tersebut, bukan sekadar tebakan statistik dari data pelatihannya.
Mengapa RAG Lebih Unggul Dibandingkan Fine-Tuning?
Banyak pengembang mempertimbangkan antara menggunakan Retrieval-Augmented Generation atau melakukan fine-tuning (penyetelan ulang) pada model. Keduanya memiliki tujuan serupa, yaitu menyesuaikan AI dengan kebutuhan spesifik, namun pendekatannya sangat berbeda.
Fine-tuning mengharuskan Anda melatih ulang sebagian parameter model menggunakan kumpulan data baru. Proses ini membutuhkan daya komputasi tinggi, biaya besar, dan waktu yang tidak sedikit. Selain itu, jika data sumber berubah, Anda harus melakukan pelatihan ulang. Sebaliknya, RAG hanya memerlukan pembaruan pada basis data vektor. Jika ada dokumen baru, Anda cukup menambahkannya ke indeks tanpa menyentuh model bahasanya sama sekali.
Keunggulan lain dari RAG adalah transparansi. Karena jawaban disusun berdasarkan dokumen yang diambil, sistem dapat menyertakan kutipan atau tautan rujukan. Hal ini sangat penting untuk aplikasi di sektor hukum, medis, atau keuangan yang menuntut akuntabilitas tinggi terhadap setiap informasi yang disajikan.
Langkah Praktis Membangun Sistem RAG Sederhana
Jika Anda tertarik bereksperimen dengan Retrieval-Augmented Generation, berikut adalah alur kerja dasar yang umum digunakan oleh para pengembang perangkat lunak:
- Siapkan Dokumen: Kumpulkan teks yang ingin dijadikan basis pengetahuan. Bersihkan formatnya agar hanya berisi teks murni yang bermakna.
- Pilih Model Embedding: Gunakan model seperti yang tersedia melalui API penyedia layanan AI untuk mengubah teks menjadi vektor. Pastikan model ini mendukung bahasa yang Anda gunakan.
- Gunakan Basis Data Vektor: Simpan hasil embedding ke dalam basis data vektor. Ada banyak pilihan perangkat lunak sumber terbuka yang bisa dijalankan secara lokal maupun di lingkungan cloud.
- Rancang Pipeline Pencarian: Tulis kode untuk menerima masukan pengguna, mengubahnya menjadi vektor, dan mengambil dokumen teratas yang paling mirip dari basis data.
- Integrasikan dengan LLM: Gabungkan pertanyaan dan dokumen hasil pencarian ke dalam satu string instruksi, lalu kirimkan ke model bahasa untuk mendapatkan jawaban akhir.
Berikut adalah contoh struktur logika sederhana dalam bentuk pseudocode yang menggambarkan alur tersebut:
query = "Apa kebijakan pengembalian barang?"
query_vector = embed(query)
retrieved_docs = vector_db.search(query_vector, top_k=3)
prompt = f"Jawab pertanyaan berdasarkan konteks berikut:\nKonteks: {retrieved_docs}\nPertanyaan: {query}"
response = llm.generate(prompt)
Tantangan yang Perlu Diperhatikan
Meskipun Retrieval-Augmented Generation menawarkan banyak keuntungan, pendekatan ini bukan tanpa hambatan. Kualitas jawaban sangat bergantung pada kualitas pencarian. Jika sistem gagal menemukan dokumen yang tepat, LLM mungkin tetap akan berhalusinasi atau menyatakan bahwa informasi tidak tersedia. Oleh karena itu, strategi pemotongan teks (chunking strategy) dan pemilihan model embedding yang presisi menjadi faktor penentu keberhasilan.
Selain itu, menambahkan dokumen eksternal ke dalam prompt akan memperpanjang jumlah token yang diproses. Hal ini berdampak langsung pada latensi respons dan biaya penggunaan API. Pengembang harus menyeimbangkan antara jumlah konteks yang diberikan dan efisiensi komputasi yang dibutuhkan agar sistem tetap responsif bagi pengguna akhir.
Kesimpulan
Referensi terkait: strategi chunking dan pemilihan embedding untuk pipeline RAG serta dokumentasi RAG di Hugging Face.
Retrieval-Augmented Generation telah membuktikan diri sebagai solusi pragmatis untuk menjembatani kesenjangan antara kemampuan bahasa LLM dan kebutuhan akan informasi yang akurat serta mutakhir. Dengan memisahkan penyimpanan pengetahuan dari proses pembangkitan teks, RAG memberikan fleksibilitas yang sulit dicapai oleh metode pelatihan konvensional. Bagi organisasi maupun pengembang individu yang ingin membangun asisten AI berbasis data internal, memahami dan menerapkan arsitektur ini adalah langkah strategis yang sangat relevan di era kecerdasan buatan saat ini.