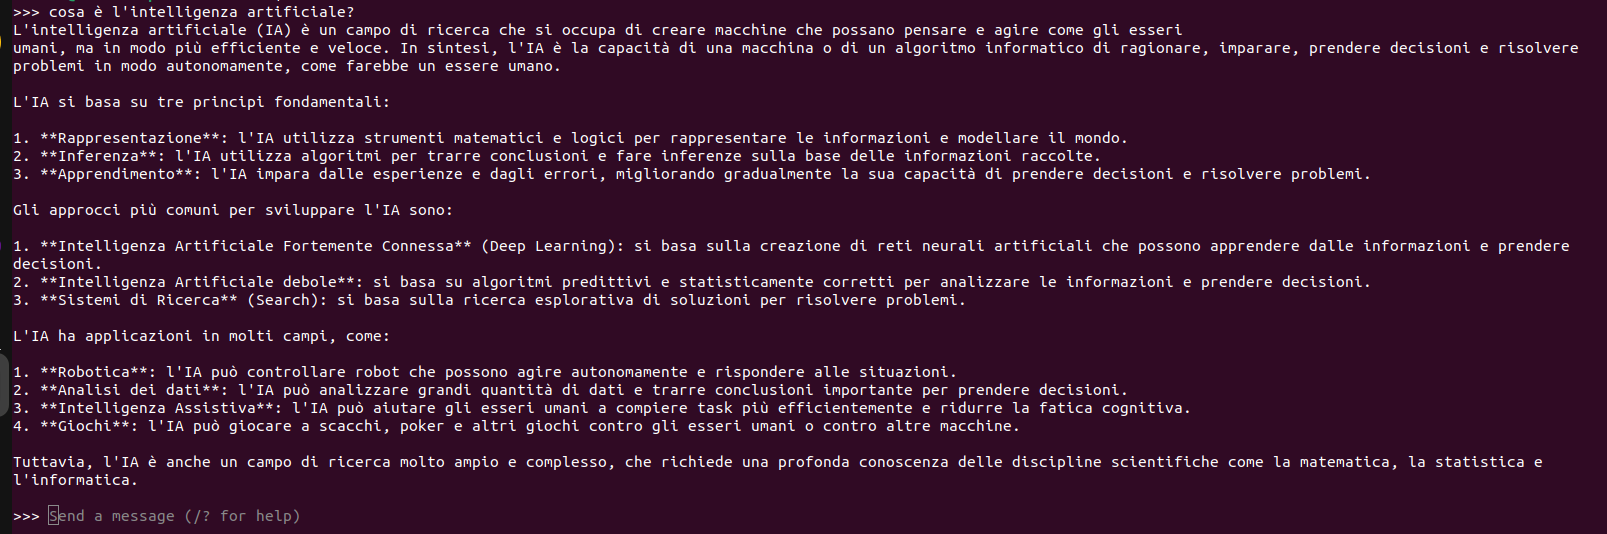
Menjalankan model kecerdasan buatan tidak lagi harus bergantung pada layanan komputasi awan yang membutuhkan koneksi internet stabil dan biaya berlangganan bulanan. Dengan hadirnya Ollama, pengembang maupun pengguna umum kini dapat menjalankan model bahasa besar (Large Language Model/LLM) langsung di komputer pribadi mereka. Perangkat lunak sumber terbuka ini menyederhanakan proses pengelolaan, penarikan, dan eksekusi model AI secara lokal dengan antarmuka baris perintah yang intuitif.
Penggunaan AI lokal menawarkan sejumlah keuntungan signifikan. Privasi data menjadi lebih terjamin karena seluruh pemrosesan terjadi di dalam mesin Anda sendiri, tanpa ada informasi yang dikirim ke server pihak ketiga. Selain itu, latensi respons bisa jauh lebih cepat jika perangkat keras yang digunakan memadai. Dalam panduan ini, kita akan membahas langkah-langkah praktis untuk mulai menggunakan Ollama dari awal hingga siap dipakai bekerja.
Apa Itu Ollama dan Mengapa Populer?
Ollama adalah kerangka kerja (framework) ringan yang dirancang khusus untuk mempermudah proses menjalankan LLM secara lokal. Sebelum alat ini tersedia, menyiapkan lingkungan kerja untuk menjalankan model seperti Llama atau Mistral sering kali melibatkan konfigurasi dependensi Python yang rumit, pengelolaan memori manual, dan pemahaman mendalam tentang arsitektur model.
Ollama mengatasi hambatan tersebut dengan mengemas semua kebutuhan ke dalam satu sistem yang terpadu. Pendekatannya mirip dengan cara Docker mengelola kontainer aplikasi; Anda cukup memanggil nama model, dan sistem akan mengurus pengunduhan, kuantisasi, serta alokasi sumber daya secara otomatis. Hal inilah yang membuat Ollama sangat populer di kalangan pengembang perangkat lunak dan peneliti AI.
Prasyarat Sistem untuk Menjalankan AI Lokal
Sebelum melakukan instalasi, pastikan perangkat Anda memenuhi persyaratan dasar agar proses inferensi berjalan lancar. Menjalankan model AI membutuhkan sumber daya komputasi yang lumayan besar, terutama pada sektor memori.
- Sistem Operasi: Mendukung macOS, Linux, dan Windows (tersedia versi pratinjau atau rilis resmi tergantung pembaruan terkini).
- RAM: Minimal 8 GB untuk model berukuran kecil (sekitar 3 miliar parameter). Disarankan 16 GB atau lebih untuk model berukuran sedang hingga besar (7 miliar parameter ke atas).
- GPU: Tidak wajib, tetapi sangat disarankan. GPU dari NVIDIA dengan dukungan CUDA atau chip Apple Silicon (M1/M2/M3) akan mempercepat waktu respons secara drastis dibandingkan hanya mengandalkan CPU.
- Ruang Penyimpanan: Siapkan ruang kosong minimal 10-20 GB untuk menyimpan berkas model yang akan diunduh.
Cara Instalasi Ollama di Berbagai Platform
Proses pemasangan Ollama sangat singkat dan disesuaikan dengan sistem operasi yang Anda gunakan. Berikut adalah panduan instalasinya.
Instalasi di macOS dan Windows
Untuk pengguna macOS dan Windows, cara termudah adalah mengunduh aplikasi instalator langsung dari situs web resmi Ollama. Setelah berkas diunduh, jalankan instalator dan ikuti petunjuk di layar. Aplikasi akan berjalan di latar belakang dan menyediakan layanan melalui antarmuka baris perintah.
Instalasi di Linux
Pengguna Linux dapat memasang Ollama hanya dengan satu baris perintah di terminal. Buka terminal Anda dan jalankan skrip instalasi berikut:
curl -fsSL https://ollama.com/install.sh | shSkrip ini akan secara otomatis mendeteksi distribusi Linux Anda, mengunduh binari yang sesuai, dan mengonfigurasi layanan sistem agar Ollama berjalan sebagai daemon di latar belakang. Jika Anda berada di balik proksi atau menggunakan cermin privat, konfigurasikan pengaturan tersebut di lingkungan sistem atau berkas konfigurasi manajer paket Anda sebelum menjalankan skrip di atas.
Menarik dan Menjalankan Model Pertama Anda
Setelah instalasi selesai, Anda bisa langsung mengunduh dan berinteraksi dengan model AI. Ollama menyediakan pustaka model yang berisi berbagai varian LLM populer seperti Llama 3, Mistral, Gemma, dan Phi-3.
Untuk memulai percakapan dengan sebuah model, gunakan perintah run diikuti dengan nama model. Sebagai contoh, untuk menjalankan model Llama 3 berukuran 8 miliar parameter, ketik perintah berikut di terminal:
ollama run llama3Jika model belum ada di komputer Anda, Ollama akan otomatis mengunduhnya terlebih dahulu. Setelah selesai, kursor akan berubah menjadi mode interaktif di mana Anda bisa langsung mengetikkan pertanyaan atau instruksi. Untuk keluar dari sesi obrolan, ketik /bye atau tekan kombinasi tombol keluar standar terminal.
Anda juga dapat melihat daftar model yang telah diunduh ke perangkat Anda dengan menjalankan perintah:
ollama listMengintegrasikan Ollama ke dalam Alur Kerja Pengembangan
Kekuatan utama Ollama tidak hanya terletak pada mode obrolan interaktifnya, melainkan juga kemampuannya menyajikan API REST bawaan. Secara default, layanan ini berjalan di port 11434 pada mesin lokal Anda. Fitur ini memungkinkan pengembang untuk menghubungkan model AI ke aplikasi lain dengan mudah.
Anda dapat mengirimkan permintaan ke model menggunakan utilitas seperti cURL. Berikut adalah contoh permintaan untuk menghasilkan teks melalui API:
curl http://localhost:11434/api/generate -d '{
  "model": "llama3",
  "prompt": "Jelaskan konsep komputasi awan dalam satu paragraf."
}'
Dengan pendekatan ini, Ollama dapat disambungkan ke berbagai antarmuka pihak ketiga, ekstensi editor kode, atau bahkan skrip otomatisasi Python. Pemahaman tentang integrasi API ini sangat berguna bagi Anda yang ingin membangun aplikasi berbasis AI tanpa bergantung pada infrastruktur eksternal. Memahami cara kerja jaringan lokal saat mengakses API ini juga berkaitan erat dengan prinsip dasar dalam pengelolaan jaringan dan konektivitas perangkat yang aman dan efisien.
Tips Optimalisasi Kinerja Model AI Lokal
Agar pengalaman menggunakan AI lokal tetap responsif, perhatikan beberapa praktik terbaik berikut:
- Pilih ukuran model yang tepat: Jangan memaksakan menjalankan model berukuran 70 miliar parameter jika RAM Anda terbatas. Gunakan model berukuran 3B atau 7B yang sudah dioptimalkan untuk perangkat konsumen.
- Manfaatkan kuantisasi: Pustaka Ollama umumnya menyediakan model yang sudah dikuantisasi (misalnya format 4-bit). Ini mengurangi jejak memori secara signifikan dengan penurunan kualitas jawaban yang sangat minim.
- Tutup aplikasi berat lainnya: Inferensi AI memakan banyak sumber daya. Pastikan aplikasi yang tidak perlu ditutup saat Anda sedang memproses tugas berat melalui Ollama.
Penggunaan perangkat lunak sumber terbuka untuk memproses data sensitif juga sejalan dengan upaya menjaga keamanan siber. Ketika data tidak pernah meninggalkan jaringan lokal Anda, risiko intersepsi oleh pihak luar dapat ditekan seminimal mungkin. Hal ini menjadi pertimbangan penting bagi perusahaan yang menerapkan kebijakan keamanan data dan privasi ketat dalam operasional sehari-hari mereka.
Kesimpulan
Artikel terkait: membangun pipeline RAG dengan chunking dan embedding.
Ollama mengubah paradigma akses terhadap teknologi kecerdasan buatan generatif menjadi jauh lebih demokratis dan privat. Dengan proses instalasi yang sederhana, dukungan lintas platform, dan penyediaan API bawaan, perangkat lunak ini menjadi fondasi yang solid bagi siapa saja yang ingin bereksperimen atau mengembangkan solusi berbasis LLM di mesin lokal. Mulailah dengan mengunduh satu model kecil, pahami perintah dasarnya, dan eksplorasi bagaimana AI lokal dapat meningkatkan produktivitas Anda tanpa harus bergantung pada koneksi internet.